SHAP e LIME per la spiegabilità dei modelli, in concreto

Un modello di machine learning che raggiunge un’ottima accuratezza non è automaticamente un modello adatto per andare in produzione. Se non riusciamo a spiegare perché ha preso una certa decisione, rischiamo di avere tra le mani una scatola nera, difficile da debuggare e, in alcuni contesti (sanità, finanza, HR), anche da usare legalmente.
È qui che entra in gioco la spiegabilità dei modelli, nota anche come Explainable AI (XAI). In questo articolo vediamo come funzionano due delle tecniche più usate in questo ambito, SHAP e LIME, e come applicarle in concreto con Python su un modello reale.
- Perché ci serve la spiegabilità
- Spiegabilità globale vs locale
- Il dataset e il modello di esempio
- LIME: spiegazioni locali tramite approssimazione
- SHAP: spiegazioni basate sulla teoria dei giochi
- SHAP a livello globale
- SHAP vs LIME: quando usare l’uno o l’altro
- Conclusione
Perché ci serve la spiegabilità
Immagina di aver addestrato un modello che decide se approvare o meno un prestito bancario. Il modello ha un’accuratezza del 95%, ma un giorno rifiuta la richiesta di un cliente che, sulla carta, sembrava avere tutti i requisiti. A quel punto qualcuno ti chiederà: “perché il modello ha detto di no?”
Se il modello è una regressione lineare, la risposta è semplice: basta guardare i coefficienti per capire l’importanza di ciascuna feature. Per esempio, può essere che il modello dia la maggior parte del peso al reddito del cliente, senza concentrarsi su altri fattori. Ma se stiamo parlando di un Random Forest, un Gradient Boosting o una rete neurale, la risposta non è affatto immediata, perché le decisioni derivano dall’interazione non lineare di centinaia (o migliaia) di parametri.
La spiegabilità serve a colmare questo divario, offrendo strumenti che permettono di capire quali feature hanno influenzato una predizione, e con quale peso. Questo torna utile per almeno quattro motivi:
- Fiducia: capire il “perché” di una decisione aiuta chi utilizza il modello a fidarsi (o a diffidare correttamente) del risultato.
- Debug: se il modello si basa su una feature “sbagliata”, la spiegabilità ce lo mostra subito.
- Compliance normativa: in molti settori regolamentati, come quello bancario o sanitario, non è possibile prendere decisioni automatizzate senza poterle giustificare.
- Miglioramento del modello: capire cosa “guarda” il modello aiuta a fare feature engineering più mirato.
Spiegabilità globale vs locale
Prima di entrare nel codice, è importante distinguere due livelli di spiegabilità:
- Spiegabilità globale: risponde alla domanda “quali feature sono importanti per il modello nel suo complesso?”. La risposta a questa domanda ci dà una visione d’insieme del comportamento del modello su tutto il dataset.
- Spiegabilità locale: risponde alla domanda “perché il modello ha predetto questo valore per questa specifica istanza?”. È utile quando dobbiamo giustificare una singola decisione.
LIME nasce principalmente per la spiegabilità locale, mentre SHAP è in grado di offrire sia spiegazioni locali che, aggregandole, una visione globale del modello.
Il dataset e il modello di esempio
Per rendere l’esempio concreto, usiamo il classico dataset Breast Cancer incluso in scikit-learn, che contiene misure diagnostiche di tumori al seno, con l’obiettivo di classificarli come benigni o maligni. Addestriamo un modello un po’ più “opaco” di una regressione lineare, come un RandomForestClassifier.
import pandas as pd
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier

data = load_breast_cancer()
X = pd.DataFrame(data.data, columns=data.feature_names)
y = data.target

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

model = RandomForestClassifier(n_estimators=200, random_state=42)
model.fit(X_train, y_train)

print(f"Accuracy sul test set: {model.score(X_test, y_test):.2f}")
Il modello ottiene un’ottima accuratezza, ma come si comporta “internamente”? Andiamo a scoprirlo prima con LIME, poi con SHAP.
Per seguire questo esempio installa le due librerie con
pip install lime shap.
LIME: spiegazioni locali tramite approssimazione
LIME (Local Interpretable Model-agnostic Explanations) parte da un’idea semplice quanto elegante: anche se il modello complessivo è non lineare e difficile da interpretare, nell’intorno di una singola predizione possiamo approssimarlo con un modello semplice, tipicamente lineare, e usare quel modello semplificato per spiegare la decisione.
In pratica, per spiegare una predizione, LIME:
- Genera tante piccole perturbazioni dell’istanza da spiegare (variando leggermente i valori delle feature).
- Chiede al modello originale di predire l’output per ciascuna di queste varianti.
- Addestra un modello lineare “locale” su questi dati, pesando maggiormente i punti più vicini all’istanza originale.
- Usa i coefficienti di questo modello lineare per stimare l’importanza di ogni feature per quella specifica predizione.
In altre parole, LIME costruisce un piccolo “modello interpretabile” che funziona bene solo nell’intorno della predizione che vogliamo spiegare.
import lime
import lime.lime_tabular

explainer = lime.lime_tabular.LimeTabularExplainer(
    training_data=X_train.values,
    feature_names=X_train.columns.tolist(),
    class_names=["benigno", "maligno"],
    mode="classification"
)

istanza = X_test.iloc[0]

spiegazione = explainer.explain_instance(
    data_row=istanza.values,
    predict_fn=model.predict_proba,
    num_features=8
)

for feature, peso in spiegazione.as_list():
    print(f"{feature}: {peso:.4f}")
Il risultato è una lista di feature con un peso associato: valori positivi spingono la predizione verso la classe “maligno”, valori negativi verso “benigno”. Puoi anche visualizzare il risultato in modo grafico direttamente in un notebook Jupyter con spiegazione.show_in_notebook(), oppure salvarlo come HTML con spiegazione.save_to_file("spiegazione.html").
Eseguendo il codice su una delle istanze del test set del dataset Breast Cancer, otteniamo un grafico come questo:
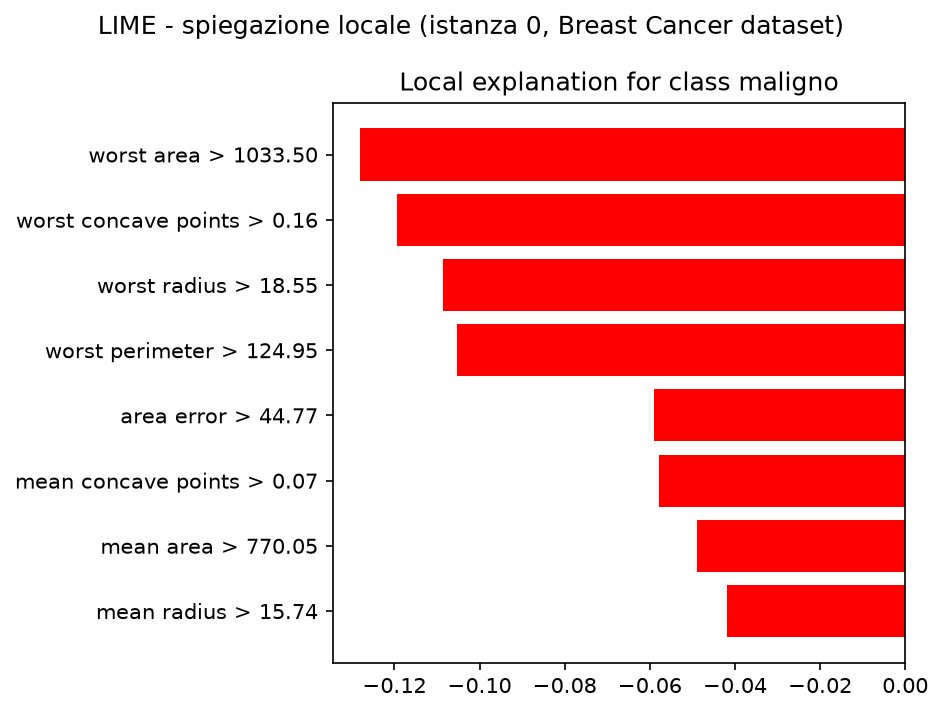
In questo caso, il modello classifica l’istanza come maligna, e le feature che pesano di più sono worst area, worst concave points e worst radius: valori elevati di queste tre misure spingono la predizione verso la classe maligna.
Il grande vantaggio di LIME è che è model-agnostic: funziona con qualunque modello, dal più semplice al più complesso, perché tratta il modello come una scatola nera di cui interroga solo l’output. Il rovescio della medaglia è che, essendo un’approssimazione locale basata su campionamento casuale, i risultati possono variare leggermente a ogni esecuzione, ed è sensibile alla scelta di come vengono generate le perturbazioni.
SHAP: spiegazioni basate sulla teoria dei giochi
SHAP (SHapley Additive exPlanations) affronta lo stesso problema con un approccio più solido dal punto di vista teorico, basato sui valori di Shapley, un concetto preso in prestito dalla teoria dei giochi cooperativi.
L’idea di base: immagina ogni feature come un “giocatore” che partecipa a un gioco cooperativo il cui risultato finale è la predizione del modello. Il valore di Shapley di una feature rappresenta il suo contributo medio all’output, calcolato considerando tutte le possibili combinazioni (chiamate coalizioni) in cui quella feature può comparire insieme alle altre.
Questo approccio garantisce alcune proprietà matematiche molto interessanti, tra cui:
- Efficienza: la somma dei contributi di tutte le feature è uguale esattamente alla differenza tra la predizione e il valore medio (baseline) del modello.
- Coerenza: se una feature contribuisce di più in un modello rispetto a un altro, il suo valore SHAP non può essere più basso.
Nella pratica, calcolare esattamente i valori di Shapley per ogni possibile combinazione di feature sarebbe computazionalmente proibitivo, quindi SHAP offre diversi explainer ottimizzati per specifiche famiglie di modelli, tra cui TreeExplainer (velocissimo per modelli ad albero come Random Forest e XGBoost), LinearExplainer e KernelExplainer (più generico, ma più lento, model-agnostic come LIME).
Dato che il nostro modello è un RandomForestClassifier, possiamo sfruttare TreeExplainer:
import shap

explainer = shap.TreeExplainer(model)

shap_values = explainer.shap_values(X_test)

istanza_idx = 0

shap.force_plot(
    explainer.expected_value[1],
    shap_values[1][istanza_idx],
    X_test.iloc[istanza_idx],
    matplotlib=True
)
Il force_plot mostra visivamente come ogni feature “spinge” la predizione, partendo dal valore atteso (expected_value, ossia la predizione media del modello) verso il valore finale predetto per quella specifica istanza: le feature in rosso spingono verso la classe positiva, quelle in blu verso la classe negativa, con una lunghezza proporzionale all’intensità del contributo.
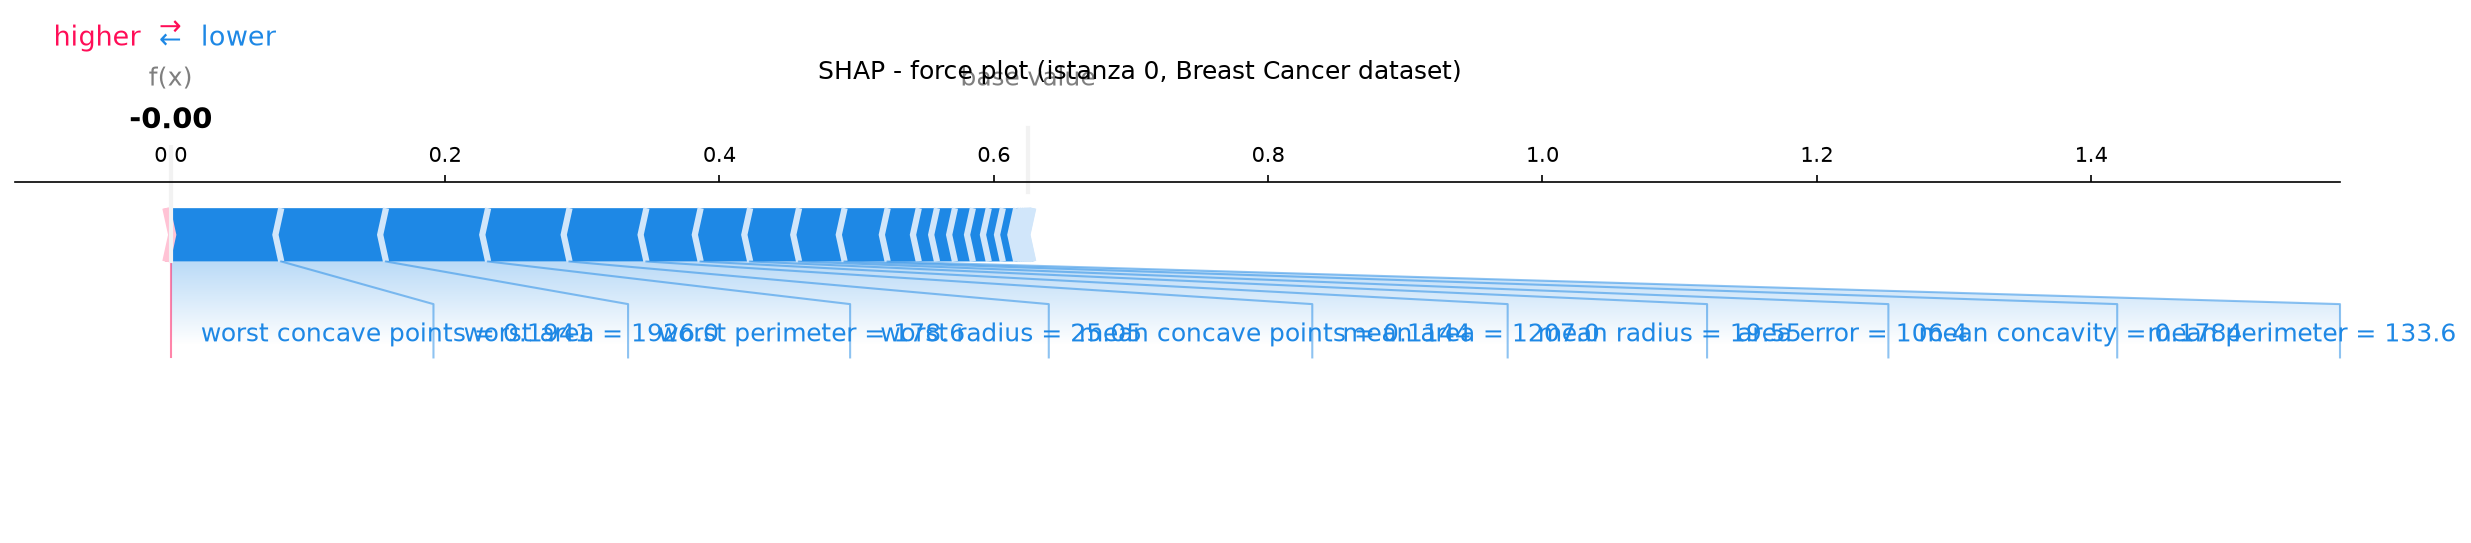
Confrontando questo grafico con quello ottenuto in precedenza con LIME, noterai che le feature più rilevanti sono sostanzialmente le stesse (worst area, worst concave points, worst radius), a conferma che i due metodi, pur con approcci diversi, tendono a essere coerenti tra loro sulle feature davvero rilevanti.
SHAP a livello globale
Uno dei punti di forza di SHAP è che, calcolando i valori di Shapley per tutte le istanze del test set, possiamo aggregarli per ottenere una visione globale del comportamento del modello, cosa che con LIME richiederebbe un lavoro manuale aggiuntivo.
shap.summary_plot(shap_values[1], X_test, feature_names=X_train.columns)
Questo grafico (chiamato beeswarm plot) mostra, per ogni feature, la distribuzione del suo impatto su tutte le predizioni del test set: le feature sono ordinate dalla più alla meno importante, e il colore di ogni punto indica se il valore della feature per quell’istanza era alto (rosso) o basso (blu). In questo modo capiamo non solo quali feature contano di più, ma anche in che direzione influenzano il modello.
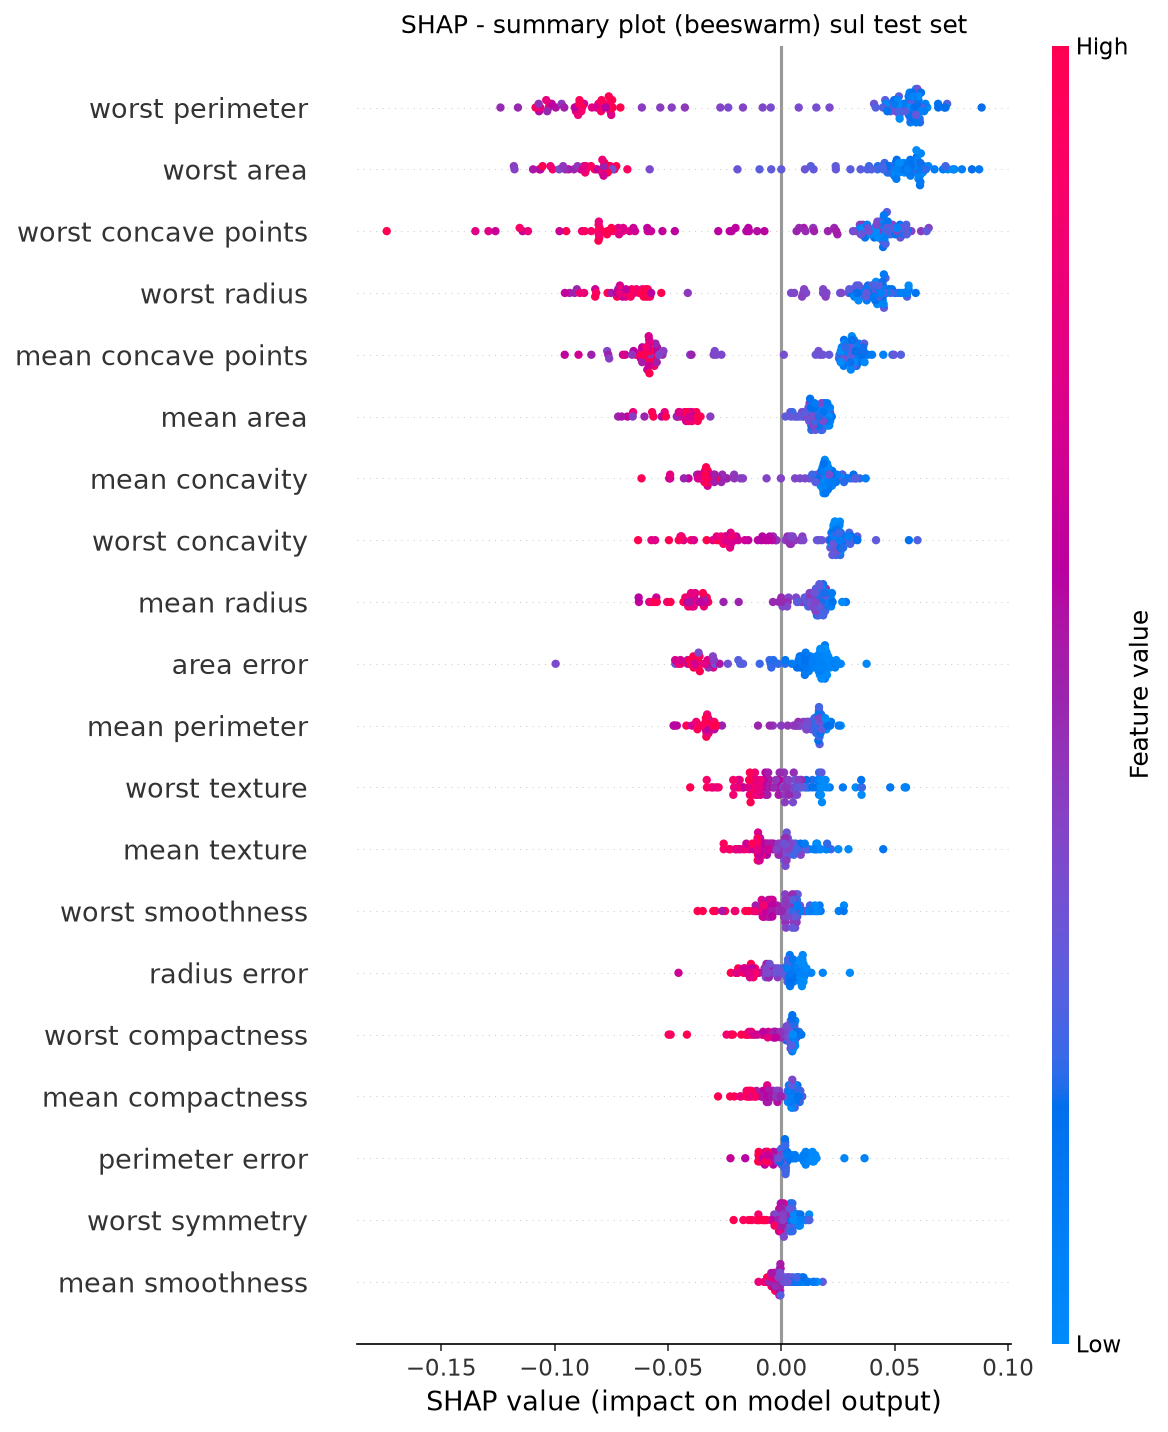
Nel nostro caso, valori bassi (blu) di worst concave points, worst perimeter e worst radius spingono verso la classe benigna, mentre valori alti (rossi) delle stesse feature spingono verso la classe maligna: un pattern coerente con la conoscenza clinica del dominio, un ottimo segnale che il modello ha imparato relazioni sensate e non artefatti del dataset.
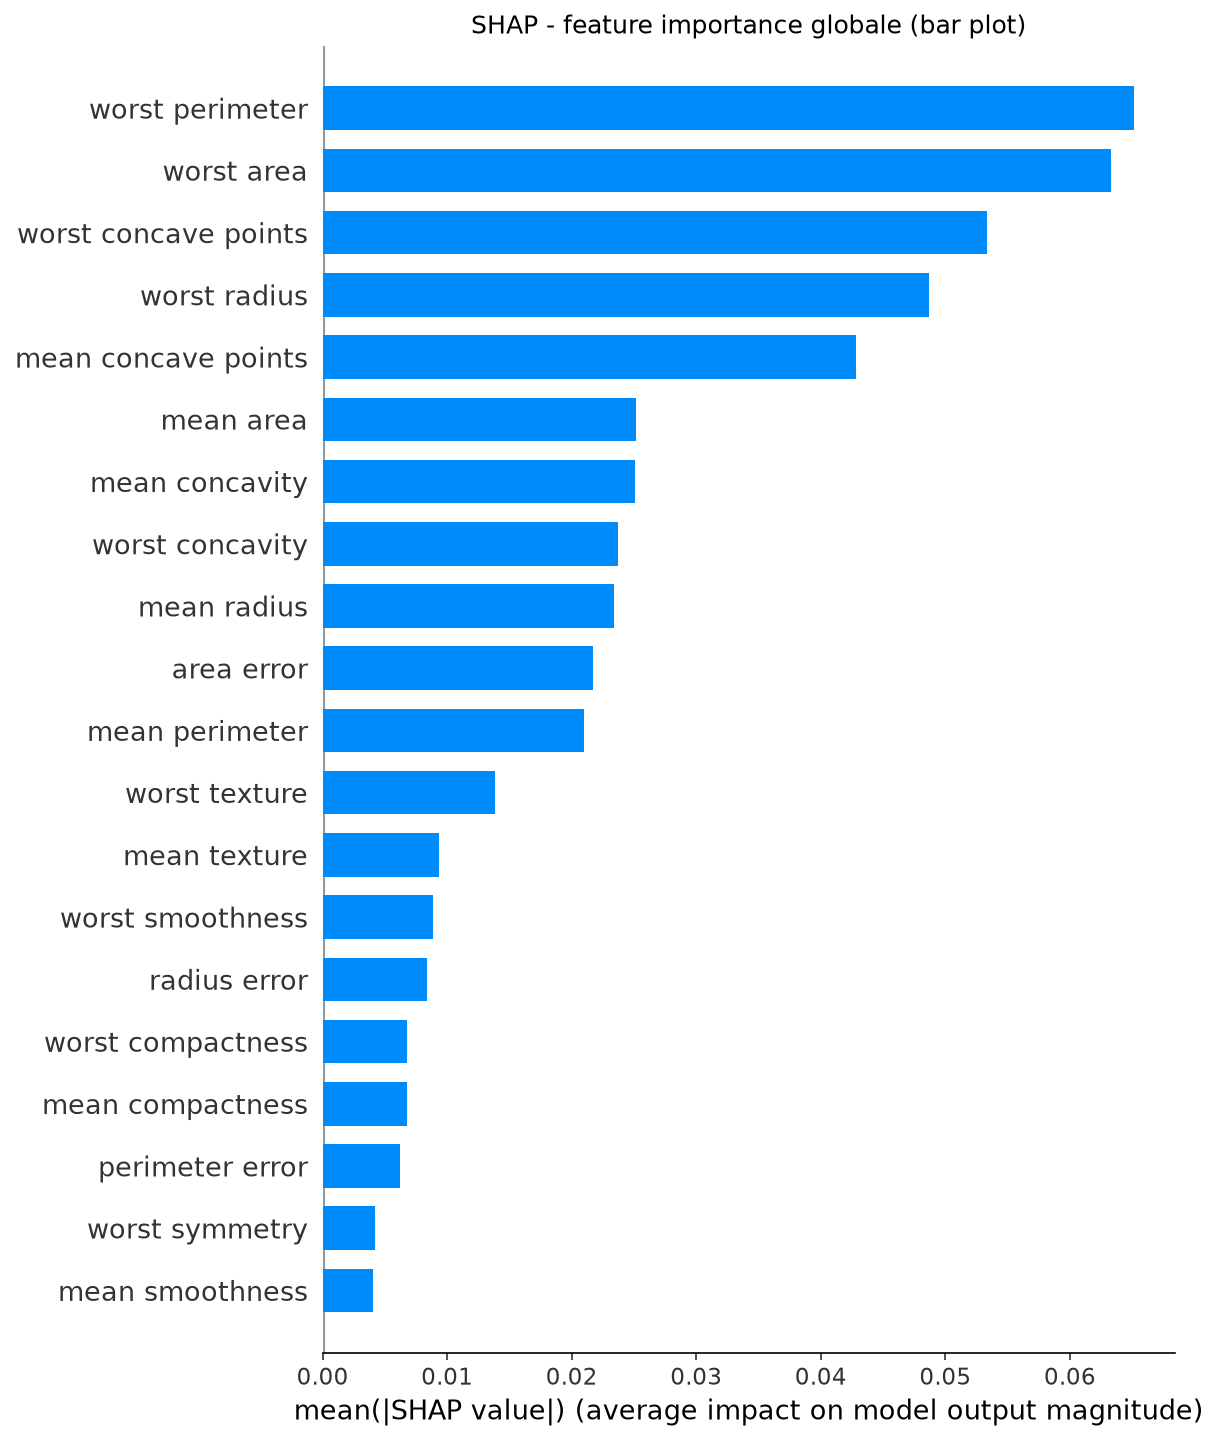
Possiamo ottenere anche una versione più sintetica, simile alla classica feature importance, con:
shap.summary_plot(shap_values[1], X_test, feature_names=X_train.columns, plot_type="bar")
SHAP vs LIME: quando usare l’uno o l’altro
Entrambi gli strumenti rispondono alla stessa domanda (“perché il modello ha deciso così?”), ma con approcci e compromessi diversi:
| Aspetto | LIME | SHAP |
|---|---|---|
| Base teorica | Approssimazione locale con modello surrogato | Valori di Shapley (teoria dei giochi) |
| Consistenza dei risultati | Può variare tra esecuzioni diverse | Deterministico (con TreeExplainer/LinearExplainer) |
| Velocità | Generalmente veloce | Molto veloce sui modelli ad albero, più lento con KernelExplainer |
| Spiegazioni globali | Richiede aggregazione manuale | Nativa, tramite summary_plot |
| Model-agnostic | Sì | Sì (con KernelExplainer), ma più efficiente con explainer specifici |
Nella pratica, se hai bisogno di uno strumento rapido, universale e “quick and dirty” per avere un’idea di massima, LIME resta una scelta valida. Se invece lavori con modelli ad albero o lineari e vuoi spiegazioni più rigorose, coerenti e facilmente aggregabili in una vista globale, SHAP è quasi sempre la scelta migliore, ed è per questo che è diventato lo standard de facto nella maggior parte dei progetti di ML in produzione.
Conclusione
Costruire un modello accurato è solo metà del lavoro: l’altra metà è capire, e far capire, perché prende determinate decisioni. SHAP e LIME ci danno gli strumenti per aprire la scatola nera dei nostri modelli, sia a livello di singola predizione che di comportamento complessivo.
Non si tratta soltanto di un esercizio accademico: in molti contesti reali, dalla sanità alla finanza, la spiegabilità non è un “nice to have” ma un requisito imprescindibile, sia per motivi etici che normativi. Includere SHAP o LIME nella propria pipeline di machine learning, fin dalle prime fasi di validazione del modello, è un’ottima abitudine da acquisire per costruire sistemi di AI più affidabili, trasparenti e sicuri.
Articoli Correlati